“Hier is de data. Succes ermee.”
De meeste mensen die met data werken, hebben haar zo ontvangen. Een bestand, een export, een link naar een tabel. Soms een kort mailtje. Zelden meer. En dan begint het echte werk. Wat betekent deze kolom? Waarom zijn sommige waarden leeg? Is dit dezelfde “klant” als in ons eigen systeem? Mogen we dit hier eigenlijk wel voor gebruiken? Niemand heeft het zo bedacht. Niemand is slordig. Het is gewoon hoe data altijd tussen teams en organisaties heeft bewogen: de data gaat, en de kennis erover blijft achter.
Bedenk wat dat betekent. Het team achter het bronsysteem begrijpt de data, omdat het er elke dag mee werkt. De ontvanger moet dat begrip reconstrueren uit kolomnamen, voorbeelden en gesprekken. Daarna doet de volgende ontvanger, op een andere afdeling, een jaar later, misschien nadat het oorspronkelijke team allang verder is gegaan, het allemaal opnieuw. We blijven betalen om kennis terug te halen die er al was, daar waar de data begon.
Lange tijd was dat vervelend, maar te overzien.
Stel je voor hoe het vroeger ging. Een afdeling had cijfers nodig voor de maandelijkse managementrapportage. Iemand vroeg een export aan, een analist was een paar dagen bezig om er wijs uit te worden, en een handjevol mensen keek naar het resultaat voordat het in een vergadering belandde. De data kwam uit een paar systemen die iedereen kende, en je wist altijd wie je kon bellen: de collega die de rapportage had gebouwd, de applicatiebeheerder die wist waarom een veld anders werd gebruikt, de analist die je bij de koffie waarschuwde om de cijfers van vóór de systeemwissel niet te vertrouwen. De context van de data zat in de hoofden van mensen, en reisde met hen mee. Zag een getal er vreemd uit, dan viel dat iemand op, omdat er tussen de data en elke beslissing een mens stond. Er gingen dingen mis, maar de fouten waren klein, kwamen langzaam en werden meestal opgemerkt.
Stel je nu de situatie van vandaag voor. Dezelfde organisatie haalt data uit tientallen bronnen, binnen en buiten de eigen muren. Die stroomt continu platforms binnen, wordt automatisch gecombineerd en voedt dashboards, algoritmes en AI-agents die er binnen seconden op handelen. Niemand kijkt nog naar elk resultaat; het is simpelweg te veel. De mens die vroeger tussen de data en de beslissing stond, is ongemerkt uit de keten verdwenen.
De manier waarop we data overdragen is niet veranderd. Wat er daarna mee gebeurt, is volledig veranderd. Een gok die een analist vroeger een middag kostte, kan nu ongecontroleerd in duizenden beslissingen terechtkomen.
En bedenk op hoeveel plekken dat gebeurt. Het datawarehouse- en BI-team putten tegelijk uit veel bronsystemen: CRM, ERP, financiën, HR en nog tientallen meer. Elk daarvan moet worden begrepen, en het werk vermenigvuldigt zich met elke bron die erbij komt. Hetzelfde geldt voor de analisten, de data scientists, het AI-project, de partner die een export ontvangt, het team dat de volgende migratie voorbereidt. Ieder van hen gaat met dezelfde data zitten en ontrafelt die vanaf nul: hoe is ze opgebouwd, wat betekenen de waarden, welke regels gelden er? Ieder van hen is er weken mee bezig, met echte kosten in tijd en geld.
En ieder van hen vult de gaten met aannames. Wat betekent een leeg veld? Is deze waarde een fout of een uitzondering? Hoe goed moet de data zijn, en is ze goed genoeg? Elk team beantwoordt die vragen anders, zonder te weten dat de anderen hetzelfde werk deden.
Het resultaat: dezelfde bron, op vijf verschillende manieren begrepen, door vijf teams die er allemaal niet helemaal zeker van zijn dat ze het goed hebben. Zo vertellen twee rapporten op basis van dezelfde data uiteindelijk verschillende verhalen, en kan niemand met zekerheid zeggen welke klopt.
Daarom is “succes ermee” ook niet langer alleen vervelend. Het is een doodlopende weg geworden. Elke nieuwe bron voegt een nieuwe gokronde toe, elke nieuwe ontvanger herhaalt die, en elke AI-agent handelt op het resultaat voordat iemand ernaar heeft gekeken.
- Je kunt er niet uit komen door meer mensen aan te nemen. Er zullen nooit genoeg mensen zijn om data te ontrafelen in het tempo waarin ze nu binnenkomt en nodig is.
- Je kunt er achteraf niet uit komen door te controleren. Tegen de tijd dat een fout boven water komt, zit ze al in veel beslissingen.
- Je ziet niet waar het zich opstapelt. De kosten blijven stijgen, de fouten blijven zich vermenigvuldigen en het risico blijft groeien waar niemand het ziet.
Ga zo door, en het wordt niet langzaam beter; het wordt snel slechter.
Wat er veranderd is
Er zijn vier dingen tegelijk veranderd, en samen maken ze de oude manier onwerkbaar.
Er worden nu vragen gesteld. Toezichthouders, auditors en het publiek willen steeds vaker weten waar data vandaan komt, of ze geschikt was voor de beslissing die ze ondersteunde, en of ze op die manier gebruikt mocht worden. Voor bepaalde AI-systemen met een hoog risico stelt de Europese AI-verordening eisen aan de herkomst van data, hoe die is voorbereid en of ze geschikt is. “We namen aan dat…” is geen antwoord dat standhoudt.
Data reist verder, en haar spoor raakt zoek. Ze verhuist naar cloudplatforms, naar partners, naar ketenorganisaties, naar gedeelde dataspaces. Ze wordt gecombineerd met data uit bronnen die niemand in de kamer ooit heeft gezien. De persoon die haar kon uitleggen is niet meer één telefoontje verwijderd. Vaak weet niemand zelfs wie die persoon is.
En hoe verder data reist, hoe belangrijker twee eenvoudige vragen worden: waar komt dit vandaan, en waar is het naartoe gegaan? Als een bron fout blijkt te zijn, wil je weten welke rapporten, modellen en beslissingen erop zijn gebouwd. Als een beslissing ter discussie staat, wil je die kunnen herleiden tot de data erachter.
Vandaag volgen we het spoor van de data. Tools zoals datacatalogi kijken hoe data door pipelines beweegt en proberen haar lineage te reconstrueren uit de voetsporen die ze achterlaat. Dat is zwaar werk, en het stopt vaak bij de grens van één platform. De export naar een partner, de spreadsheet die iemand heeft bewerkt, de AI-agent die data via een API ophaalde, het systeem dat vorig jaar is gemigreerd: daar raakt het spoor zoek. De data reist verder; het verhaal van waar ze is geweest, reist niet mee.
Oude data is waardevol geworden. Lange tijd was data een bijproduct van een proces. Was het proces klaar, dan werd de data gearchiveerd en vroeg niemand er meer naar. Dat beeld is veranderd. Data wordt nu gezien als een asset, zelfs als een product, dat zijn waarde behoudt lang nadat het proces dat haar maakte is afgerond. AI heeft zelfs oude data waardevol gemaakt: jaren aan historie om van te leren, patronen om te ontdekken, voorspellingen om te doen. Organisaties bewaren data langer, hergebruiken haar vaker en combineren haar op manieren die niemand voorzag toen ze werd gemaakt.
Maar die oude data heeft de systemen, de teams en de mensen die haar konden uitleggen overleefd. Haar waarde kan groeien, terwijl de kennis die nodig is om haar veilig te gebruiken ongemerkt is verdwenen. Hoe ouder de data, hoe meer we ervan willen, en hoe minder iemand ons kan vertellen wat ze betekent.
De ontvanger is niet altijd meer een mens. Data wordt steeds vaker gebruikt door AI-modellen en -agents. Een analist die een kolom niet begrijpt, aarzelt, vraagt rond, plaatst een voorbehoud. Een AI doet niets van dat alles. Ze gebruikt wat ze krijgt, snel en vol vertrouwen, of ze de data nu begreep of niet. Er is geen collega die ze kan bellen, tenzij iemand haar een route naar die kennis heeft gegeven. Dat is precies wat een paspoort doet.
Iedereen die met AI werkt, zegt nu hetzelfde: AI heeft context nodig. Er is zelfs een nieuwe naam voor: context engineering. Maar datamensen herkennen er veel van meteen in. Het is wat we al decennia doen in datawarehousing en BI: uitzoeken wat brondata betekent, hoe ze in elkaar past en welke regels gelden, en die kennis opnieuw opbouwen in modellen, definities en semantische lagen. En het is altijd onze achilleshiel geweest. Het is traag, het is duur en het is nooit af.
We kunnen dat niet allemaal nog een keer doen voor AI. We hebben er simpelweg de mensen en de tijd niet voor. En AI vraagt meer, niet minder: betere kwaliteit en diepere betekenis, expliciet vastgelegd, omdat ze anders dan een menselijke analist de gaten niet kan vullen met ervaring en gezond verstand. Als de context niet met de data meekomt, weet AI zelden wat ze mist. Ze gaat gewoon door zonder.
Elk van deze veranderingen is op zich te overzien. Samen laten ze ons steeds opnieuw hetzelfde dure werk doen: voor elk nieuw platform, elke nieuwe ontvanger, en nu ook voor AI, zonder realistische kans om het bij te houden.
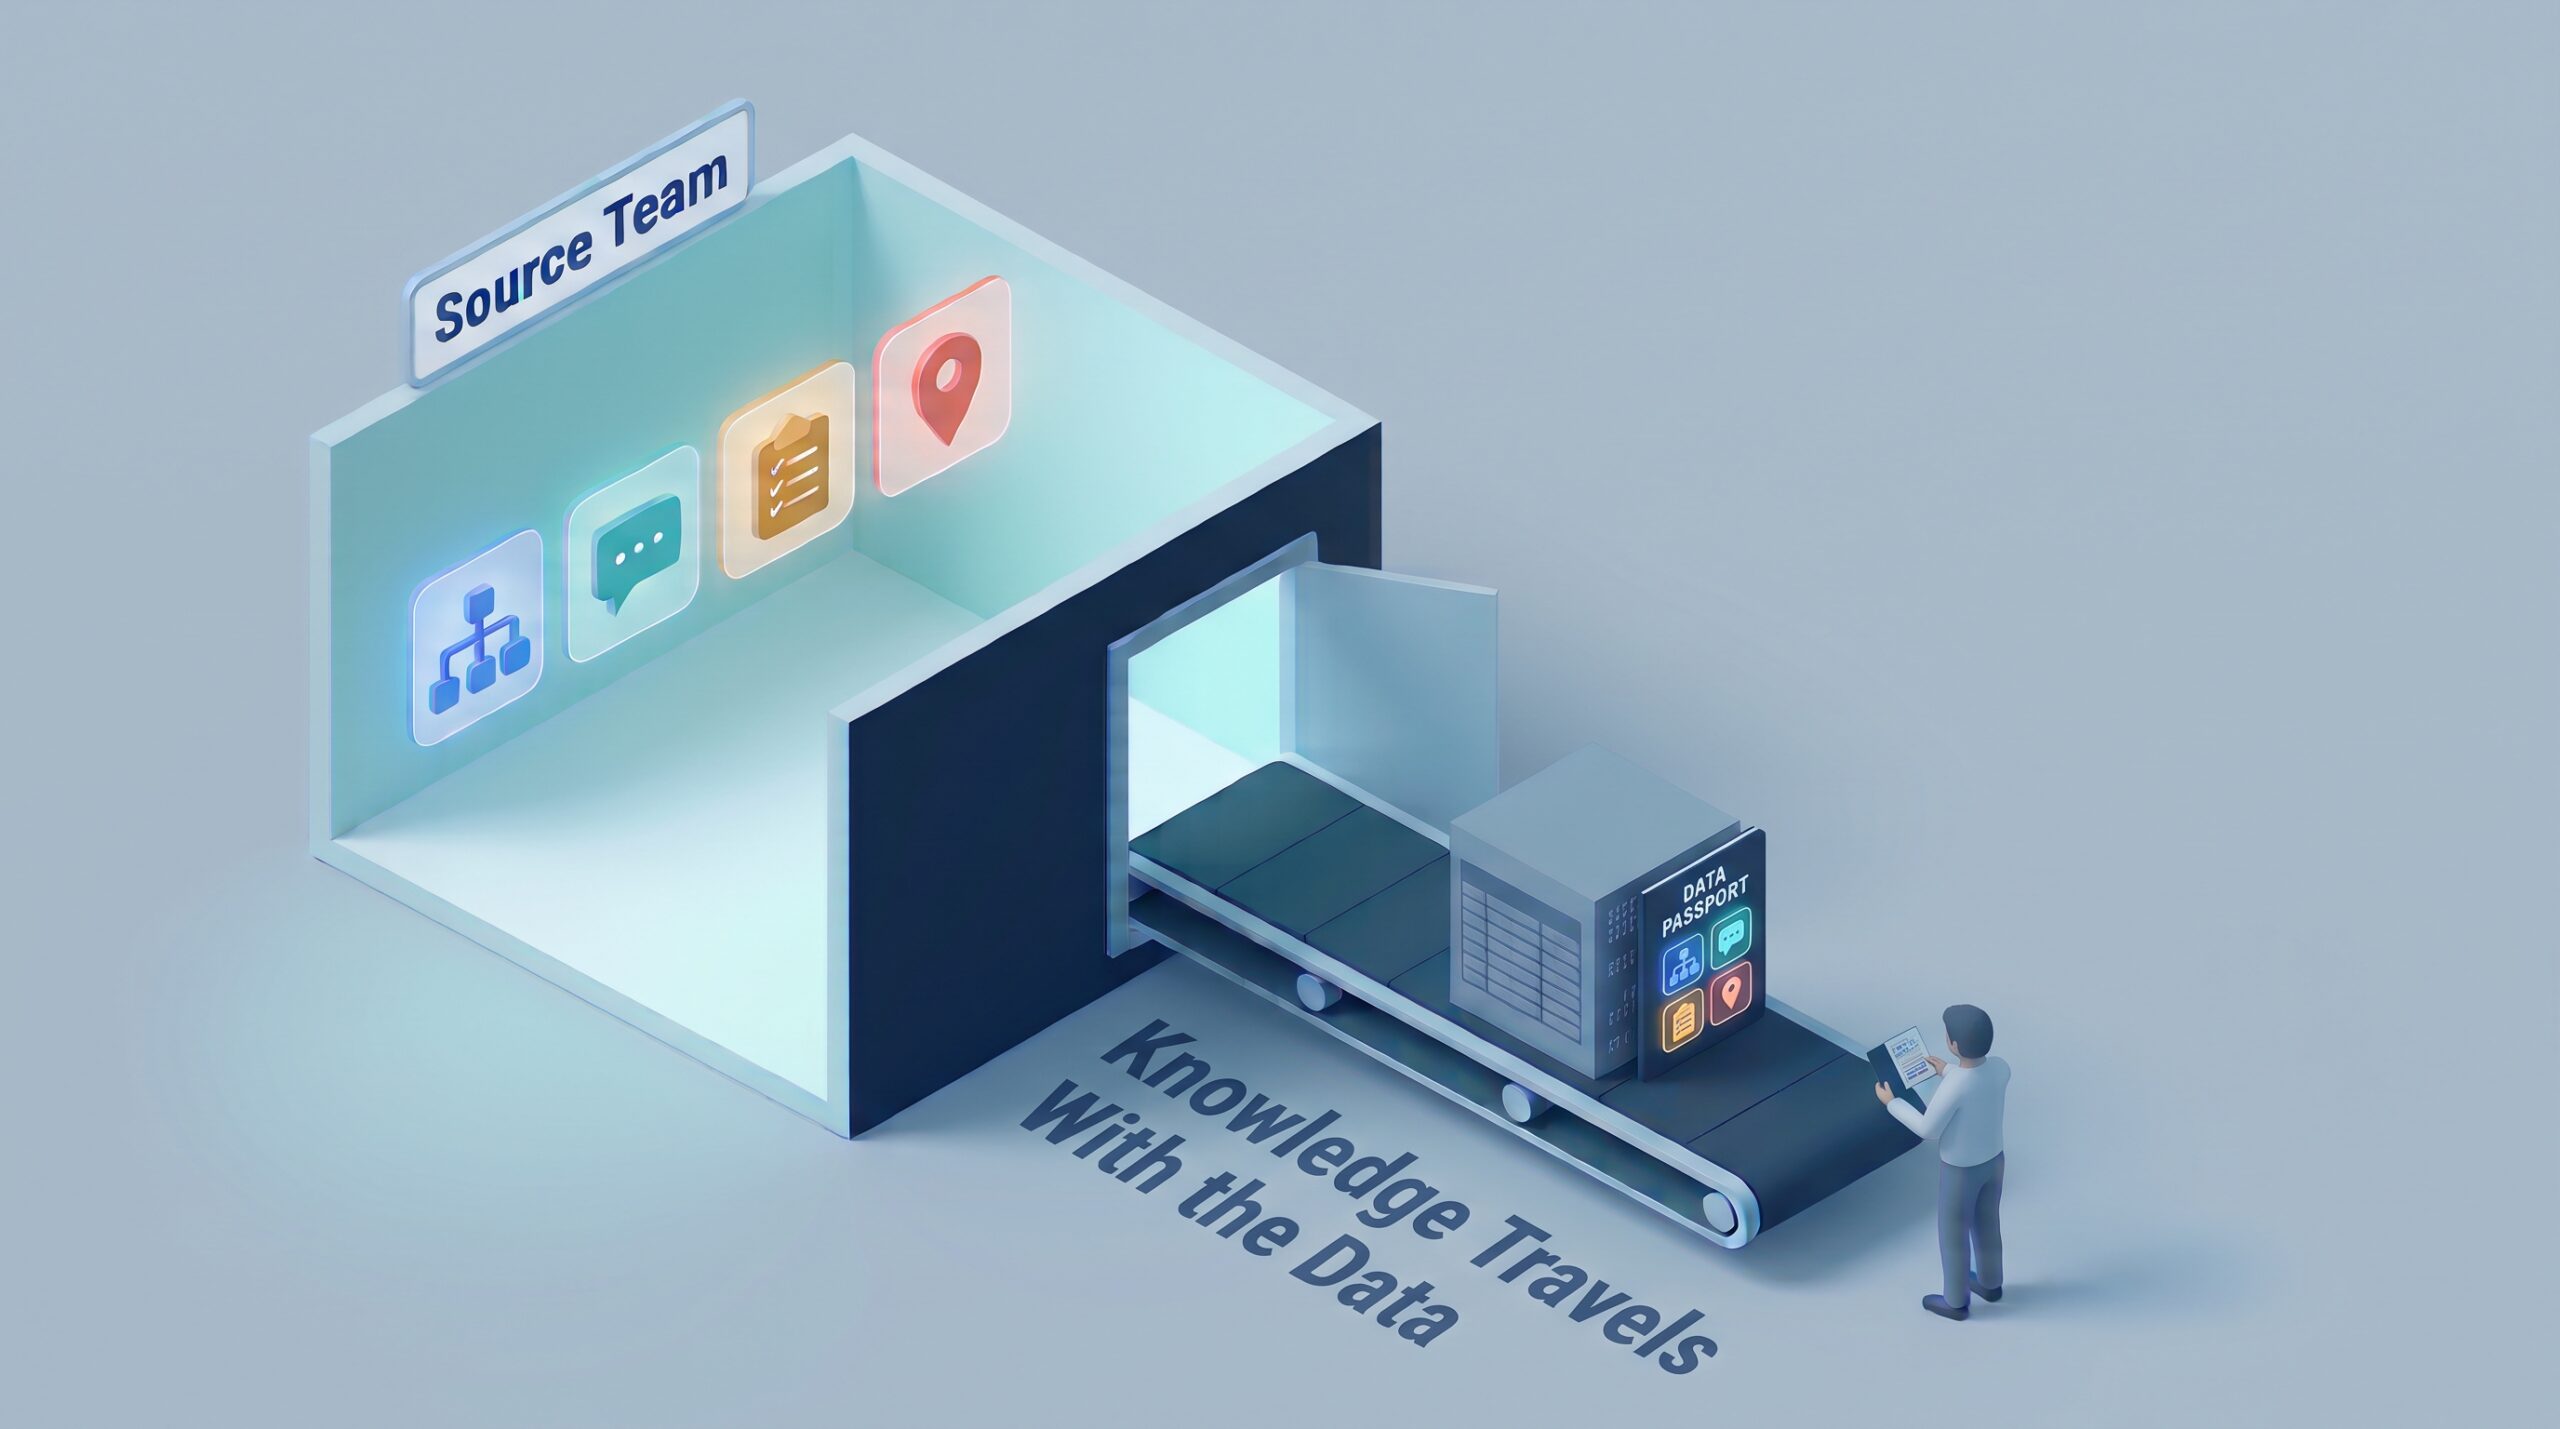
Tenzij we het anders doen. De context die AI nodig heeft, is dezelfde context die BI nodig heeft, en datadeling, en data science, en de volgende migratie naar een nieuw operationeel systeem. Als we die goed vastleggen, aan de bron, geven we ze allemaal in één keer hetzelfde fundament. En het goede nieuws: we kunnen beginnen met de technologie die we al hebben. Wat het vraagt, is dat we ons anders organiseren, zodat de mensen die de data kennen haar aan de bron vastleggen, actueel houden, en dat ze vanaf dat moment altijd met de data meereist.
Wat “succes ermee” echt kost
De kosten van data zonder papieren uiten zich zelden in één groot incident. Ze lekken weg, stil, overal.
Tijd. Elke ontvanger begint vanaf nul. Ze bestuderen voorbeelden, vergelijken kolommen, sturen mails, wachten op antwoorden. Dezelfde dataset wordt steeds opnieuw uitgezocht, door elk team dat haar gebruikt. Vraag je datamensen hoeveel van hun week opgaat aan data begrijpen in plaats van gebruiken. Het antwoord is meestal ongemakkelijk.
Verkeerde beslissingen. Als mensen gokken, zullen sommige gokken fout zijn. Een eenheid wordt verkeerd gelezen, een definitie aangenomen, een filter ontbreekt. Het rapport ziet er goed uit, het dashboard ziet er goed uit, en de beslissing die erop is gebouwd zit er stilletjes naast. Niemand merkt het, totdat de uitkomsten overduidelijk niet kloppen.
Neem een veld met de naam klant_sinds. Het rapportageteam gebruikt het als de datum waarop de klantrelatie begon. Het AI-team gebruikt het om klantloyaliteit te voorspellen. In werkelijkheid bevat het de datum waarop de klant in het huidige systeem werd geladen: elke klant van vóór de laatste migratie kreeg dezelfde datum. Beide teams verwerken het veld perfect, en beide trekken de verkeerde conclusie. Eén regel in de papieren van de data had het voorkomen.
Late verrassingen. Omdat niemand vooraf weet of een dataset bruikbaar is, komen projecten daar halverwege achter. De analyse wordt overgedaan, het AI-model opnieuw getraind, de livegang uitgesteld. De vraag “kunnen we dit gebruiken?” had op dag één beantwoord moeten zijn.
Risico dat je niet ziet. Data wordt gebruikt voor doelen waarvoor ze nooit bedoeld was, gedeeld voorbij wat de licentie toestaat, of in een AI-model gestopt zonder dat iemand wist dat er persoonsgegevens in zaten. Niet uit kwade wil, maar omdat niemand de voorwaarden heeft doorgegeven.
Migraties die meer verliezen dan data. Als een systeem wordt vervangen, komt de data meestal wel over. De bedrijfsregels, de uitzonderingen en de redenen erachter vaak niet. Het nieuwe systeem werkt, maar niemand vertrouwt het helemaal.
Niets hiervan is iemands schuld. Het is het voorspelbare gevolg van data laten reizen zonder de kennis die erbij hoort.
Als data met haar papieren komt
Op elk ander terrein waar belangrijke dingen bewegen tussen partijen die elkaar niet kennen, hebben we dit lang geleden opgelost. Een container gaat de grens niet over zonder documenten. Een medicijn verlaat de fabriek niet zonder bijsluiter. Niemand opent elke doos om te raden wat erin zit. De voedselketen gaat nog verder: elke schakel in de keten registreert waar een product vandaan kwam en waar het naartoe ging, zodat de eieren of de sla in het supermarktschap terug te voeren zijn naar de boerderij en de boer waar ze vandaan komen, en snel teruggeroepen kunnen worden als er iets mis is. Die traceerbaarheid is een groot deel van de reden waarom we vertrouwen wat we eten.
Data verdient hetzelfde: papieren die met haar meereizen, waar ze ook heen gaat. Wat ze betekent, welke regels gelden, wat je ermee mag doen en wie erachter staat. Vastgelegd aan de bron door de mensen die het weten, actueel gehouden, en leesbaar voor iedereen die haar ontvangt, mensen en machines.
Dat noem ik een datapaspoort. En daarnaast een Data Guardian: software die die papieren controleert waar data binnenkomt of vertrekt, en de overdracht toestaat, markeert of stopt volgens afgesproken regels.
Met een paspoort wordt “succes ermee” “dit is wat je moet weten”. Ontvangers beginnen bij begrip in plaats van gokken. Go/no-go-beslissingen over data worden aan het begin genomen, niet halverwege. AI krijgt de context die ze nodig heeft. En als iemand vraagt waar de data vandaan kwam en wie zei dat ze zo gebruikt mocht worden, is er een antwoord, met een naam erbij.
En we hoeven niet langer detective te spelen en een spoor te volgen, want we hebben een registratie van overal waar de data is geweest, afgestempeld door elk systeem waar ze doorheen gaat. Een paspoort draagt de herkomst van de data met zich mee en verzamelt, net als een echt paspoort, onderweg stempels: bij elke overdracht, elke combinatie, elk nieuw gebruik. Een catalogus is een bibliotheek die je moet bezoeken; een paspoort reist mee in de binnenzak van de data. Lineage hangt niet langer af van een externe tool die haar binnen één platform reconstrueert; ze reist mee met de data, over platforms en organisaties heen, waar die ook naartoe gaat.
We zijn lang geleden gestopt met het meesturen van een mens met de data. We hebben alleen nooit vervangen wat die mens wist.
Wil je zien wat een datapaspoort bevat en hoe de Data Guardian werkt, lees dan Je data heeft geen papieren – Het datapaspoort en de Data Guardian, v0.1
En één vraag om mee terug te nemen naar je organisatie: kijk naar de data achter je volgende grote beslissing. Wie heeft ervoor getekend?
Ronald Baan — Mastering Data, ronaldbaan.com